AI处理器
AI大模型支持

AI处理器<br> AI大模型支持

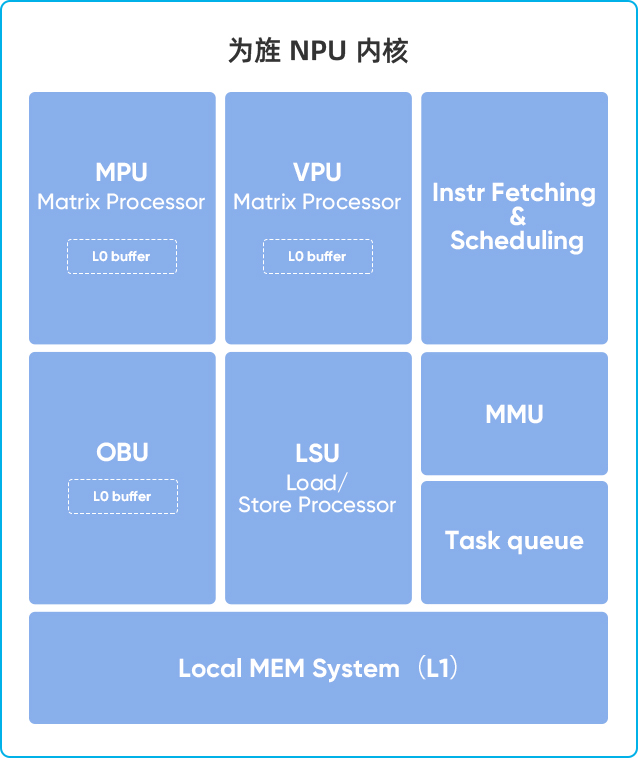
  • 高能效算力
    高能效算力
    CNN模型能效30%提升
  • 资源充分释放
    资源充分释放
    Transformer 超高MAC利用率
    (50%-60%),行业领先水平
  • 灵活全面
    灵活全面
    模型和算子支持全面
    算子级可编程200+
  • 场景全能
    场景全能
    4T + 2T大小核设计灵活
    应对不同场景
  • 内存无瓶颈
    内存无瓶颈
    带宽充足,64bit LPDDR5@5500Mbps
  • 配套工具链
    配套工具链
    模型快速移植,高效
ISP处理器
极佳的图像效果

内置LTM(局部色调映射)亮区不过曝,暗区看得清多级锐化和去紫边,突出物体边缘

看得清

看得准

感知友好

支持140dB动态范围

快速AE控制

RAW域

3DNR
YUV域

3DNR

内置强光抑制算法

内置LDCE(局部对比度增强:去雾,突出物体)

RAW域

AINR

双级3DNR(时空域联合降噪),降低曝光时间,减少运动拖尾

专业ISP&PQ团队

提供专业PQ及ISP调试技术支持

全域锐化和降噪

多级串行细节增强
多级拉普拉斯金字塔算法
最大程度保留和增强纹理和细节

AI图像增强

面向机器视觉
有效提升暗光/无光场景的识别率

DIS/EIS防抖
双防抖加持
双防抖加持
全系芯片支持
DIS/EIS防抖
高性能传感器支持
高性能传感器支持
消费级三轴/六轴陀螺仪,
精准感知抖动
硬件及加速
硬件及加速
专用硬件加速,
高效处理防抖算法
暗光也清晰
暗光也清晰
多帧降噪技术
提升夜间画面稳定
智慧自适应
智慧自适应
智能感知环境光和抖动强度,
实时调参,时刻提供最优防抖效果
多场景适配
多场景适配
专业优化安防场景、
手持场景 提供稳定卓越效果
单芯片和跨设备低时延
单芯片和跨设备低时延
端到端流畅体验
端到端流畅体验
4单设备60fps 高清传输,端到端时延仅3ms 跨设备端到端时延21ms
稳定0抖动
稳定0抖动
抖动指标业内领先水平
多场景适配
多场景适配
适用于图传、内窥镜等领域
智能编码
AI超倍转码
超强码率节省
超强码率节省
5~10倍压缩倍率
(质量等级5)
标准兼容
标准兼容
输出码流完全符合H.264/H.265
标准,通用性强
高性能多路处理
高性能多路处理
支持多路视频混编
最高支持16路1080P@30fps
像素级重点保护
像素级重点保护
对价值区域画质
进行质量保护
成熟交付机制
成熟交付机制
提供样例/参考算法及商用算法
落地更便捷
快启+AE快速收敛+补光灯功耗优化
多Sensor适配
多Sensor适配
适配任意普通Sensor
无需专门对接快启Sensor
迅捷曝光
迅捷曝光
内置MCU,AE收敛快人一步
(<100ms)
快速收敛
快速收敛
快启+AE快速收敛
第一帧出图时间优于业内30%
场景赋能
场景赋能
与AOV场景组合使用
针对性优化补光灯功耗
AI赋能
AI赋能
NPU高效计算
有效信息快速识别